Během měření jsou součásti naměřených hodnot také hrubé, systematické a náhodné chyby (nejistoty). Tato úloha, s využitím dat naměřených na tenzometrickém můstku, popisuje zpracování a vyhodnocení těchto nejistot.
Proveďte kalibraci měřicího systému, celého měřicího řetězce.
Proveďte měření 3 hmotností (pro každou hmotnost soubor 30, 60, 90 hodnot).
Určete náhodné chyby jednotlivých odečtů a aritmetického průměru pro soubory 30, 60 a 90 hodnot měření a porovnejte jejich velikosti.
Sestrojte empirickou křivku četnosti chyb pro dané soubory měření a vyhodnoťte jejich průběh.
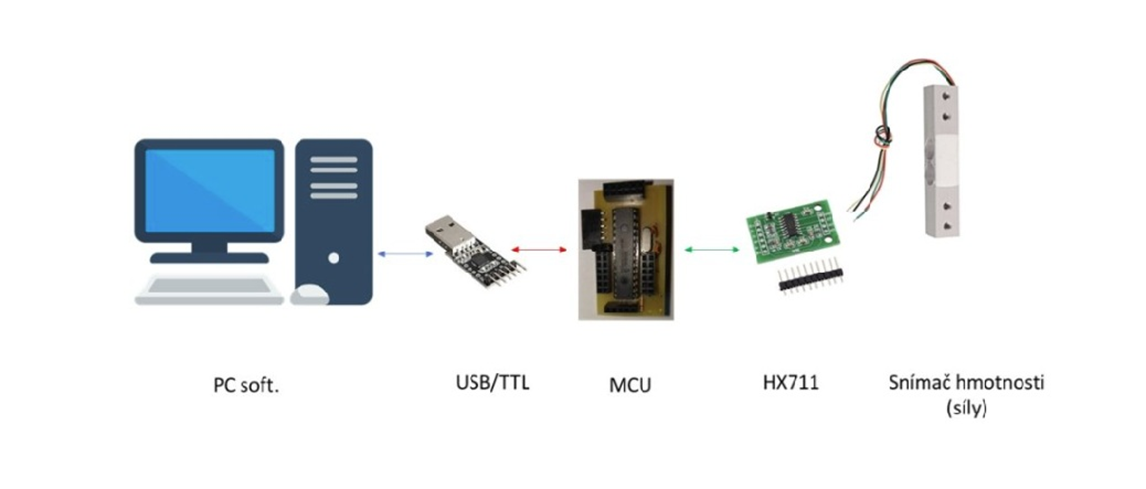
Obr. 1 Blokové schéma zapojení – měřicí řetězec
Náhodné chyby jednotlivých měření nebo aritmetického průměru je možno určit jen z většího počtu měření statistickými metodami. Již samým výpočtem aritmetického průměru ze souboru n měření se přibližujeme ke skutečné hodnotě měřené veličiny. Hovoříme o tom, že aritmetický průměr x je nejlepším odhadem skutečné hodnoty měřené veličiny xS:
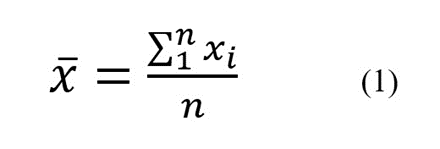
Při praktických výpočtech volíme obyčejně počet měření dosti malý, např. n = 10 či dokonce n = 5. Gaussův (normální) zákon rozdělení náhodných chyb předpokládá, že relativní četnost neboli hustota pravděpodobnosti chyby je vyjádřena vztahem:
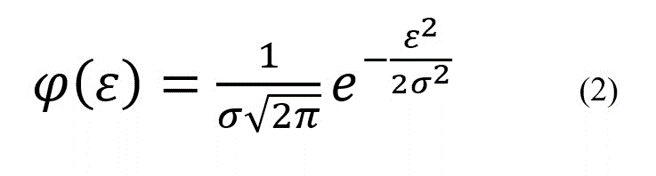
Průběh φ(ε) je znázorněn na následujícím obrázku.
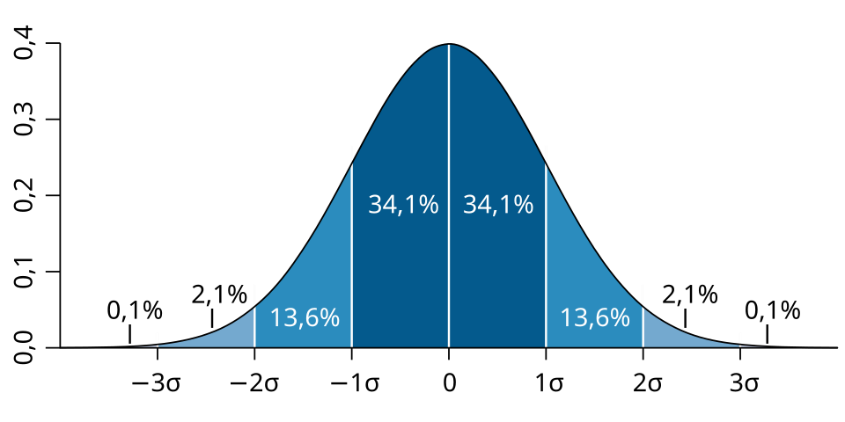
Obr. 3 Normální Gaussův zákon rozdělení náhodných chyb
Pro počet měření, tak jak to v praxi často bývá, můžeme střední kvadratickou odchylku pouze odhadnout. Tu lze pak vyjádřit vztahem:
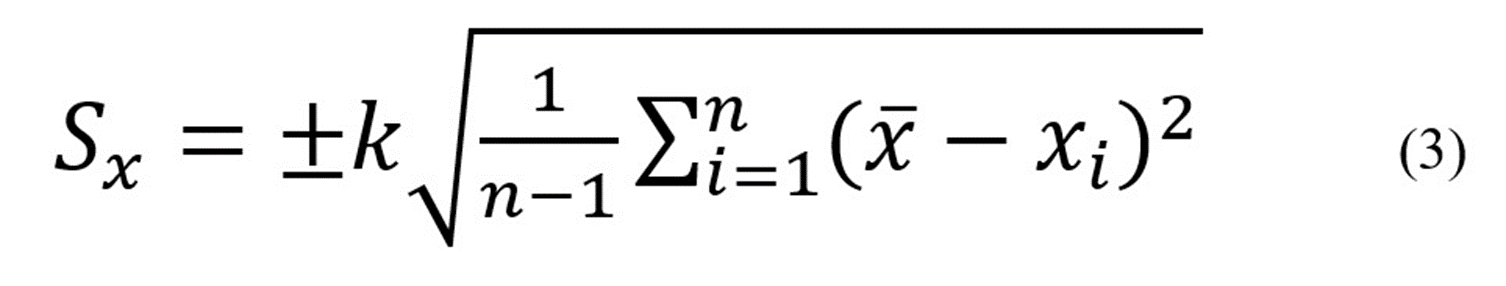
Protože se teoreticky mohou vyskytnout i chyby poměrně velké (ovšem se značně malou pravděpodobností), je možno odhad chyby měření popsat rovněž pravděpodobností, s jakou se vyskytne větší skutečná chyba v poměru k chybám menším, než je chyba vypočtená. Vztah mezi rozpětím konfidenčního intervalu (tj. k-násobkem střední kvadratické odchylky σ) a pravděpodobností, že skutečná hodnota xS bude v mezích tohoto intervalu, je zřejmý z následující tabulky.
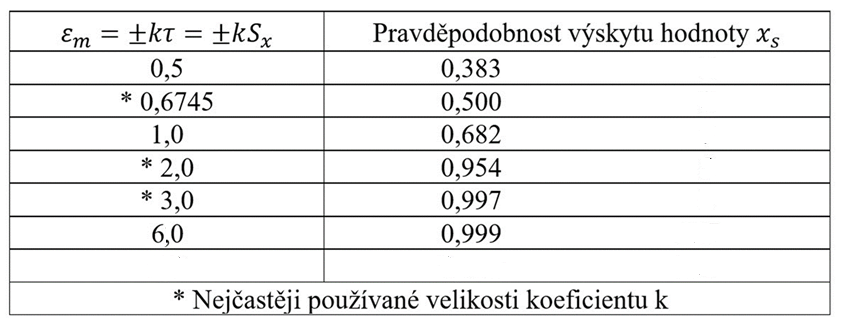
Obr. 3 Tabulka koeficientu „k“
Konfidenční interval (interval spolehlivosti) a pravděpodobnost výskytu hodnoty jsou ve statistice dvě strany téže mince. Jejich vztah je přímo úměrný. Se zvyšující se požadovanou pravděpodobností (úrovní spolehlivosti) musíte úměrně rozšířit i konfidenční interval.
V praxi volíme velikost konfidenčního intervalu a tím i součinitel k = 3, to znamená, že mezní (maximální) náhodná chyba, takže pravděpodobnost, že skutečná hodnota měřené veličiny xs se nachází v intervalu ±3SX je 99,73 %, což je hodnota dostatečně velká. Odhad chyby jednotlivých měření SX je předpokládaná chyba každého jednotlivého odečtu a počítá se proto, abychom věděli, s jakou chybou budeme na přístroji i nadále měřit za přibližně stejných podmínek. Častěji se používá odhadu náhodné chyby aritmetického průměru, která je dána vztahem 4.
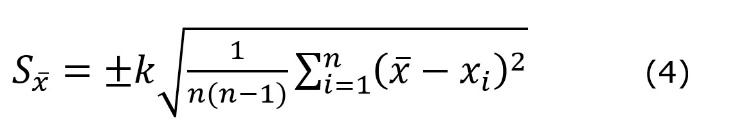
Postup při sestrojení empirické křivky četnosti chyb odpovídající přibližně Gaussovu normálnímu rozložení náhodných chyb:
1. Do grafu na vodorovnou osu vynášíme velikost jak kladných, tak záporných zdánlivých odchylek. Každou jednotlivou chybu vyznačíme na této ose kroužkem (bodem).
2. Na svislé ose vyneseme celkový počet odchylek.
3. Zvolíme vhodnou velikost intervalu I pro vodorovnou osu a nakreslíme ji na pomocný papír.
4. Tímto intervalem posouváme ve vhodně malých krocích (např. 1/5 I) po vodorovné ose z jedné strany na druhou a postupně v každém místě zjistíme počet odchylek v tom daném intervalu I, který vyneseme na svislou osu uprostřed intervalu I, v odpovídajícím měřítku.
5. Výsledná stupňovitá křivka pro dostatečně velký počet měření n (n> 100), dostatečně malý interval I a krok posuvu by se měla blížit Gaussově křivce normálního rozdělení chyb za předpokladu, že jsou vyloučeny hrubé a systematické chyby.
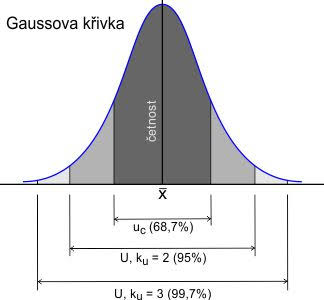
Obr. 3 Rovnoměrné a normální rozložení četnosti
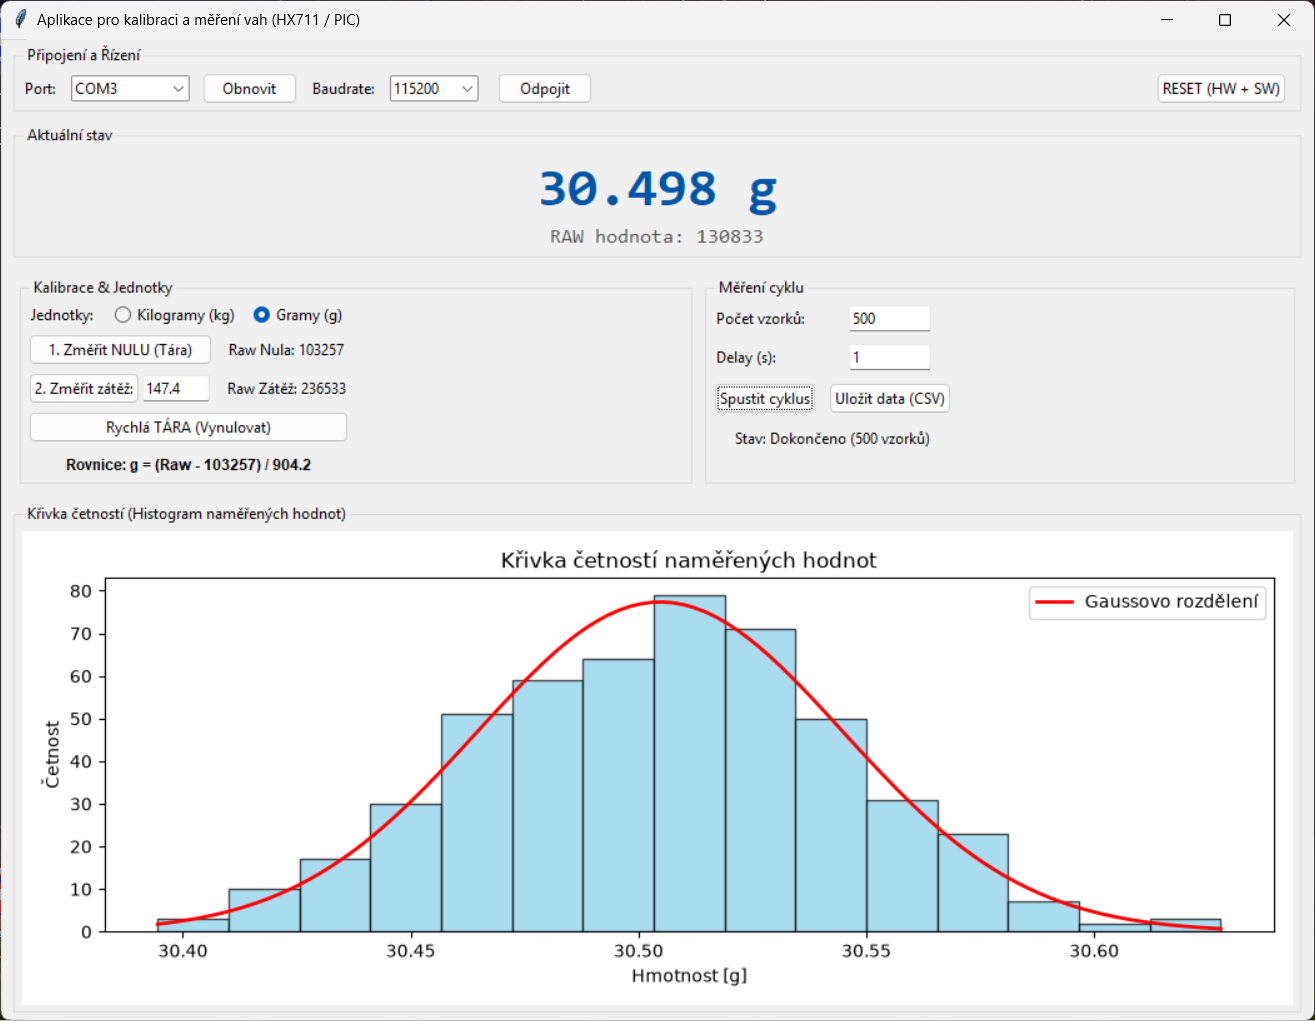
Obr. 4 Grafické rozhraní aplikace v PC
Zapojíme obvod a spustíme příslušný software v PC.
Před vlastním měřením provedeme kalibraci celého měřicího systému. Senzor má lineární závislost, proto je nutno změřit min. 2 hodnoty statické charakteristiky např. při hodnotě 0 kg a 0,5 kg.
Pro 3 vybrané hodnoty hmotnosti nakonfigurujeme software pro měření 30, 60 a 90 hodnot aktuální hmotnosti např. každé 2 s. Naměřené hodnoty uložíme do jednotlivých souborů (bude jich 6). Při těchto měřeních je nutno zachovat konstantní všechny okolnosti, ovlivňující měření (nehýbat měřicím systémem, neměnit pozici zátěže, omezit otřesy stolu apod.).
Údaje budeme uvažovat bez systematických chyb. Pro hodnoty z jednotlivých souborů se vypočte aritmetický průměr, jako odhad skutečné měřené veličiny. Pro jednotlivé počty měření n = 30, n = 60, n = 90 vypočtěte odhad chyby aritmetického průměru dle vztahu (4). Dosažené velikosti chyb vyneste do tabulky a grafu a zhodnoťte!
Ze všech měření (3 hmotnosti a 30, 60, 90 hodnot) a jejich jednotlivých odchylek [kg] sestrojte empirické Gaussovy křivku (6 křivek). Proveďte rozbor jejích průběhů, zhodnoťte vliv systematických chyb na měření. Pro zjednodušení můžete navrhnout skript např. pro MATLAB a můžete využít AI asistent.
Uveďte postup výpočtu náhodných chyb souboru n hodnot.
Jaký je rozdíl mezi odhadem chyby jednotlivých měření a odhadem chyby aritmetického průměru?
Co vyjadřuje Gaussova křivka normálního rozdělení chyb, jakým je popsána vztahem?